Lokale LLM-Inferenz für KI-Projekte in Unternehmen
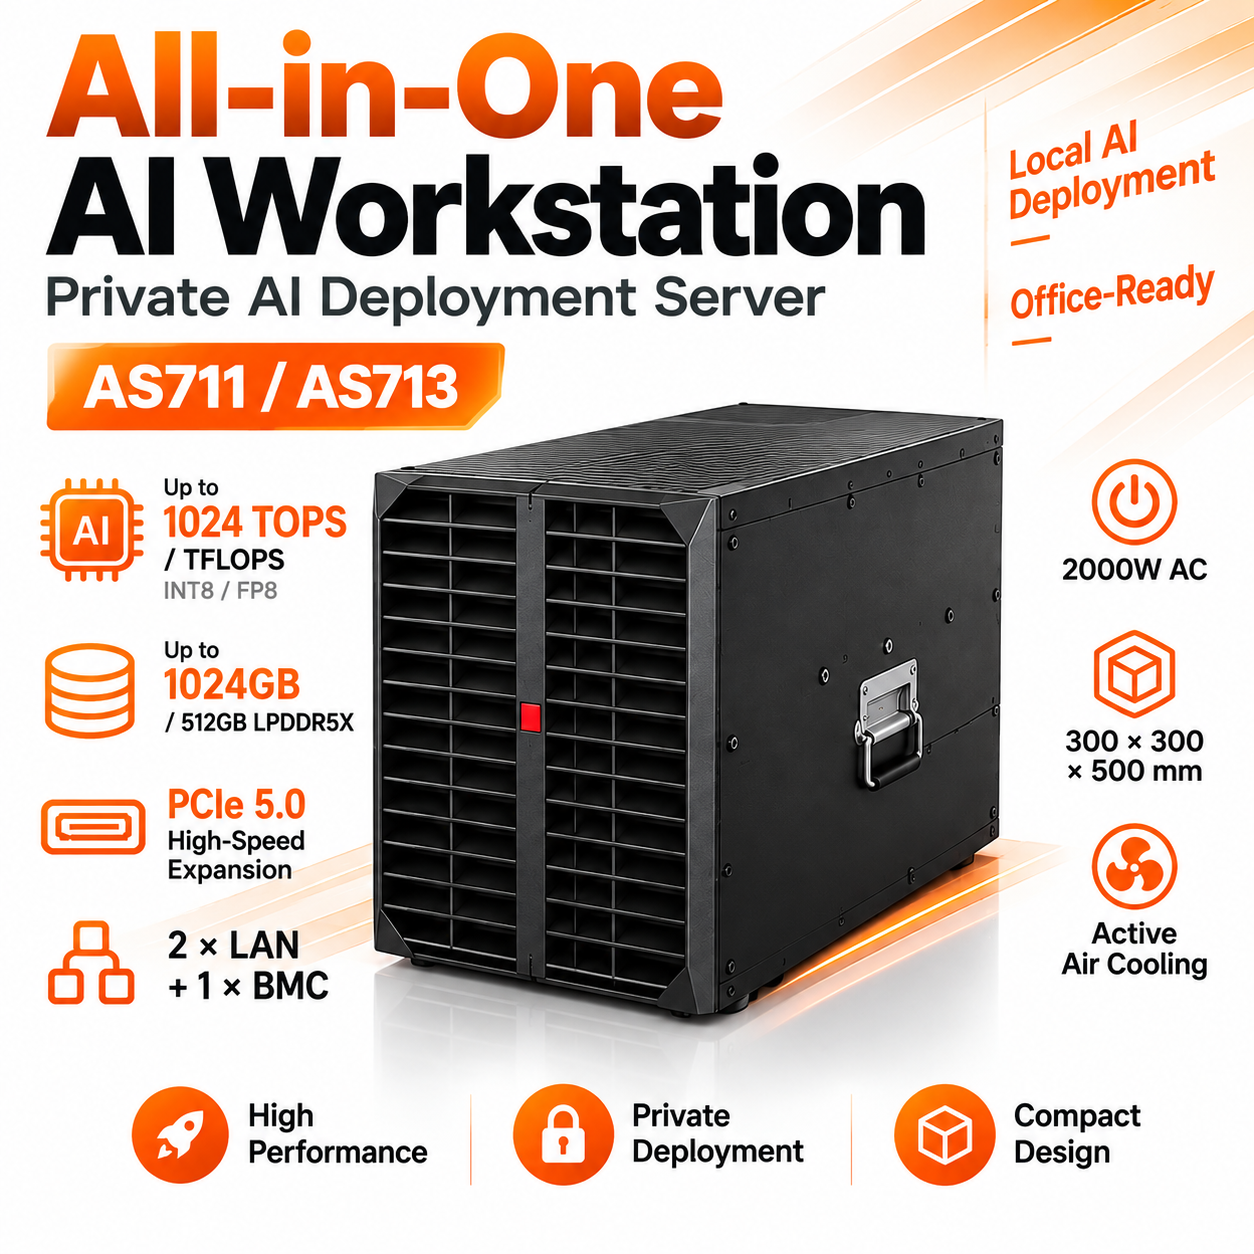
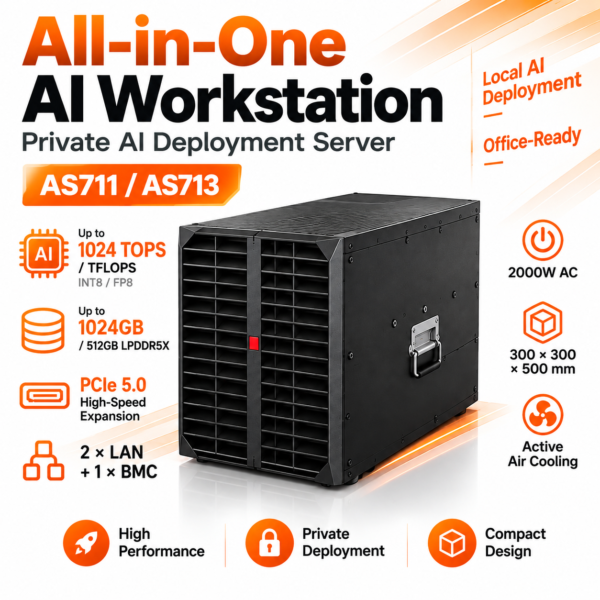
Die Modelle AS711 und AS713 sind KI-Inferenzserver mit großem Arbeitsspeicher, die für die Ausführung großer Sprachmodelle auf lokaler Infrastruktur konzipiert sind. Sie sind für KI-Implementierungen in Unternehmen, Software-Integrationsprojekte und Organisationen gedacht, die dedizierte Hardware für private KI-Anwendungen evaluieren.
Der AS713 verfügt über 512 GB LPDDR5X-Beschleunigerspeicher. Der AS711 erweitert diesen auf 1024 GB und verfügt über mehr System-RAM sowie eine zusätzliche Daten-SSD.
Beide Modelle verfügen über ein kompaktes Tower-Gehäuse mit aktiver Luftkühlung. Ubuntu und Kylin Linux sind als unterstützte Betriebssysteme aufgeführt.
AS711 vs. AS713: Welche Konfiguration sollten Sie wählen?
| Spezifikation |
AS711 |
AS713 |
| Produktpositionierung |
Konfiguration mit mehr Speicher für Modelle mit höheren Anforderungen |
Standardkonfiguration für gängige Inferenz-Bereitstellungen |
| AI-Beschleuniger-Speicher |
1024 GB LPDDR5X |
512 GB LPDDR5X |
| System-RAM |
256 GB DDR5, 4 × 64 GB |
128 GB DDR5, 2 × 64 GB |
| System-SSD |
1 × 512 GB M.2 NVMe |
1 × 512 GB M.2 NVMe |
| Daten-SSDs |
2 × 3,84 TB U.2 NVMe |
1 × 3,84 TB U.2 NVMe |
| Betriebssystemoptionen |
Ubuntu / Kylin Linux |
Ubuntu / Kylin Linux |
Wählen Sie AS713 wenn die Konfiguration des 512-GB-Beschleunigerspeichers den Anforderungen Ihres ausgewählten Modells und Ihrer Arbeitslast entspricht.
Beachten Sie AS711 wenn Ihr Projekt zusätzlichen Beschleunigerspeicher, System-RAM oder lokalen Speicher benötigt. Die Modellkompatibilität und die nutzbare Leistung sollten unabhängig von der Speicherkapazität bewertet werden.
Hardware-Spezifikationen
Die folgenden Plattformspezifikationen sind in der Produktbeschreibung AS71X v1.2.0 des Anbieters aufgeführt. Bitte bestätigen Sie die ausgewählte Konfiguration in Ihrem Angebot.
| Artikel |
Veröffentlichte Spezifikation |
| CPU |
In China entwickelter Prozessor, 2,8 GHz, 16 Kerne / 32 Threads |
| INT8-Berechnung |
1024 TOPS |
| FP8-Rechenleistung |
1024 TFLOPS |
| FP16-/BF16-Rechenleistung |
512 TFLOPS |
| TF32-Rechenleistung |
256 TFLOPS |
| FP32-Berechnung |
64 TFLOPS |
| Typ des Beschleunigerspeichers |
LPDDR5X, 8533 Mbit/s |
| Speicherbandbreite |
2184 GB/s |
| Host-Schnittstelle |
PCIe Gen 5 ×16 |
| Erweiterungssteckplätze |
2 × PCIe 5.0 ×16 |
| Netzwerkanschlüsse |
2 × Gigabit-Ethernet |
| Verbindung zur Geschäftsleitung |
1 × BMC-Management-Netzwerkanschluss |
| Externe Schnittstellen |
1 × USB Typ C, 1 × HDMI, 2 × USB 3.0 |
| Speicheranbindung |
3 × M.2-SSD-Steckplätze und 4 × U.2-2,5-Zoll-SSD-Steckplätze |
| Nennleistung des Netzteils |
2000 W Wechselstrom |
| Vom Hersteller angegebener typischer Stromverbrauch |
Unter 1000 W |
| Vom Hersteller angegebene Spitzenleistungsaufnahme |
1300 W |
| Kühlung |
Aktive Luftkühlung |
| Betriebstemperatur |
0 °C bis 40 °C |
| Abmessungen |
300 mm B × 300 mm H × 500 mm T |
Die Rechenwerte entsprechen den veröffentlichten Hardware-Spezifikationen. Der Anwendungsdurchsatz hängt vom Modell, der Genauigkeit, der Kontextlänge, der Software und der Arbeitslast ab.
Der Wert von 2000 W bezieht sich auf die Nennleistung des Netzteils und nicht auf die angegebene typische Betriebsaufnahme.
Veröffentlichte LLM-Inferenz-Benchmarks
Der Anbieter gibt unter Verwendung der FP8-Präzision und des vLLM-Benchmark-Tools folgende Ergebnisse an.
| Modell |
Kontext der Meldung |
Stapel |
Angegebener Dekodierungsdurchsatz |
| Qwen3.5-35B |
8K |
4 |
120 Token/s |
| Qwen3.5-35B |
8K |
32 |
520 Token/s |
| Qwen3.5-122B |
8K |
1 |
38 Token/s |
| Qwen3.5-122B |
8K |
8 |
195 Token/s |
| Qwen3.5-397B |
8K |
1 |
29 Token/s |
| Qwen3.5-397B |
8K |
8 |
125 Token/s |
| MiniMax-M2.7 |
8K |
1 |
30 Token/s |
| MiniMax-M2.7 |
8K |
8 |
118 Token/s |
So sind diese Ergebnisse zu interpretieren: Der Wert von 520 Tokens/s gilt für Qwen3.5-35B bei Batch 32 und der angegebenen 8K-Kontext-Einstellung. Es handelt sich um ein Durchsatzergebnis im Batch-Betrieb und nicht um eine garantierte Generierungsgeschwindigkeit für jeden einzelnen Nutzer.
Es handelt sich hierbei um vom Anbieter gemeldete Ergebnisse und nicht um unabhängige PunkHash-Benchmarks. Die Quelle gibt weder die genaue AS711- oder AS713-Konfiguration an, die für die einzelnen Tests verwendet wurde, noch den Software-Build oder die vollständigen Eingabe- und Ausgabelängen. Fordern Sie eine arbeitslastspezifische Bewertung an, bevor Sie diese Zahlen für die Kapazitätsplanung verwenden.
Quelle: AS71X-Produkteinführung v1.2.0, August 2026, Abschnitt „Benchmark“.
Modellkompatibilität und Anpassungsstatus
In der Dokumentation des Lieferanten wird zwischen abgeschlossenen Anpassungen, laufenden Optimierungen und künftigen Arbeiten unterschieden.
| Modellfamilie |
In der Produktdokumentation beschriebener Status |
| MiniMax |
Die Anpassung wurde als abgeschlossen gemeldet; die Ergebnisse des MiniMax-M2.7-Benchmarks liegen vor |
| Qwen3.5 |
Es liegen Benchmark-Ergebnisse für 35B, 122B und 397B vor; die Leistungsoptimierung wird fortgesetzt |
| GLM5-Familie |
Demonstrationen wurden erwähnt; die konkrete Unterstützung von GLM5.1 / GLM5.2 muss noch bestätigt werden |
| DeepSeek V4-Flash |
In der Roadmap für zukünftige Anpassungen aufgeführt |
In der Dokumentation wird außerdem die Unterstützung eines 32K-Kontexts mit MiniMax-M2.7 angegeben. Die oben veröffentlichte Benchmark-Tabelle basiert auf einer 8K-Kontexteinstellung.
Modellversionen und Softwarepakete werden ständig weiterentwickelt. Bitte überprüfen Sie den genauen Modell-Checkpoint, die Genauigkeit und das Bereitstellungspaket für Ihre Bestellung.
Praktische Einsatzszenarien
Wissensassistenten für Unternehmen
Bewerten Sie ein lokales Sprachmodell als Teil eines internen Wissensassistenten. Die vollständige Anwendung erfordert möglicherweise auch die Erfassung von Dokumenten, Suchsoftware, Zugriffsberechtigungen und eine Benutzeroberfläche.
Workflows für Ausschreibungen und Angebote
Mit einer geeigneten Anwendungsschicht kann die lokale Inferenz die Suche in Ausschreibungsunterlagen sowie Arbeitsabläufe zur Zusammenfassung und Erstellung von Entwürfen unterstützen. Der Anbieter zählt Lösungen zur Unterstützung bei Ausschreibungen zu seinen Zielanwendungen.
Anwendungen in den Bereichen Finanzen, Verlagswesen und Gesundheitswesen
Der Anbieter nennt das Bankwesen, den Wertpapierhandel, das Verlagswesen und das Gesundheitswesen als Zielbranchen für von Partnern bereitgestellte Lösungen. Anwendungsspezifische Integration, Zugriffskontrollen und Abnahmetests sollten im Projektumfang enthalten sein.
KI-Software und Systemintegration
Unabhängige Softwareanbieter (ISVs) und Systemintegratoren können die Modelle AS711 und AS713 als Inferenz-Hardware im Rahmen einer Kundenlösung evaluieren. Der Anbieter beschreibt die Zusammenarbeit mit Partnern in den Bereichen Modellanpassung, Bereitstellung und laufender Betrieb.
Branchenanwendungen und Software-Services sind projektabhängig und nicht automatisch im Lieferumfang der Hardware enthalten.
Fernbewertung vor der Bereitstellung
Fernprüfungen können wie folgt vereinbart werden:
- Fernzugriff auf den Desktop.
- Zugriff über die HTTP-API.
Für eine aussagekräftige Bewertung geben Sie bitte Ihr Zielmodell, die geplante Kontextlänge, die erwartete Anzahl gleichzeitiger Anfragen sowie repräsentative Aufgaben an.
Einigen Sie sich auf die Testkonfiguration und bewerten Sie die Reaktionslatenz, den Durchsatz, die Stabilität sowie die Integrationsanforderungen, bevor Sie sich für das endgültige System entscheiden.
Installations- und Lieferplanung
Prüfen Sie den Aufstellungsort hinsichtlich des angegebenen Betriebsbereichs von 0 °C bis 40 °C, der Stromversorgung und der Belüftungsanforderungen.
Obwohl das Gehäuse den Einsatz außerhalb eines herkömmlichen Rack-Formats unterstützt, hängt die Eignung für den Einsatz im Büro auch von den Anforderungen an die Wärmeableitung und die Geräuschentwicklung ab. In der Produktdokumentation sind keine Angaben zur Geräuschentwicklung enthalten.
Bitte überprüfen Sie vor der Bestellung Folgendes:
- Genaues Servermodell und genaue Komponentenkonfiguration.
- Identifizierung von Prozessoren und KI-Beschleunigern.
- Betriebssystem und Versionen der mitgelieferten Software.
- Modellanpassung und Umfang der Anwendungsinstallation.
- Netzwerkverbindung erforderlich.
- Garantie, Fernunterstützung und Reparaturvereinbarungen.
- Lieferort und Lieferzeit.
Häufig gestellte Fragen
Was ist der Hauptunterschied zwischen AS711 und AS713?
Der AS711 verfügt über 1024 GB LPDDR5X-Beschleunigerspeicher, 256 GB DDR5-System-RAM und zwei 3,84 TB große Daten-SSDs. Der AS713 verfügt über 512 GB Beschleunigerspeicher, 128 GB System-RAM und eine 3,84 TB große Daten-SSD.
Bezieht sich die angegebene Kapazität von 1024 GB auf den System-RAM?
Nein. In der Dokumentation wird die Speicherkapazität des AS711-Beschleunigers mit 1024 GB angegeben. Der separate DDR5-System-RAM beträgt 256 GB.
Kann der Server Qwen- und MiniMax-Modelle ausführen?
Der Anbieter veröffentlicht FP8-Benchmarks für Qwen3.5-35B, Qwen3.5-122B, Qwen3.5-397B und MiniMax-M2.7. Vergewissern Sie sich, welche Modellversion und welches Softwarepaket genau zu Ihrer ausgewählten Konfiguration gehören.
Bedeutet „520 Token/s“, dass jeder Nutzer diese Geschwindigkeit erhält?
Nein. Das veröffentlichte Ergebnis bezieht sich auf Qwen3.5-35B aus Batch 32 mit einer angegebenen Kontextgröße von 8K. Es sollte nicht als Geschwindigkeitsgarantie für jeden einzelnen Nutzer angesehen werden.
Verbraucht der Server ständig 2000 W?
Nein. In der Dokumentation sind ein 2000-W-Wechselstromnetzteil, eine typische Leistungsaufnahme von unter 1000 W und eine Spitzenleistungsaufnahme von 1300 W angegeben. Die tatsächliche Leistungsaufnahme hängt von der Konfiguration und der Auslastung ab.
Funktioniert es auch ohne Internetverbindung?
Eine lokale Bereitstellung bedeutet nicht automatisch einen vollständig offlineen Betrieb. Überprüfen Sie die Modellverfügbarkeit, die Softwarelizenzen, die Installationsvoraussetzungen und die externen Integrationen, falls Ihr Projekt eine Umgebung ohne Internetverbindung erfordert.
Sind KI-Anwendungen für Unternehmen enthalten?
Anwendungssoftware, Modellanpassung, Installation und Betriebsunterstützung sind vom jeweiligen Projektpaket abhängig. Bitte überprüfen Sie die im Angebot enthaltenen Leistungen.
Kann ich das System aus der Ferne testen?
Der Anbieter ermöglicht eine Evaluierung über Remote-Desktop- und HTTP-API-Zugriff. Wenden Sie sich an PunkHash, um die Verfügbarkeit von Testversionen und Ihre Anforderungen an die Arbeitslast zu besprechen.
Konfiguration oder Fernprüfung anfordern
Sag es PunkHash:
- Welches Modell oder welche Anwendung Sie ausführen möchten.
- Die von Ihnen erwartete Anzahl gleichzeitiger Benutzer oder Anfragen.
- Ihre Anforderungen hinsichtlich Kontextlänge und Antwortzeit.
- Gewünschte Menge und Lieferland.
Fordern Sie eine Konfiguration, ein Angebot oder eine Fernbewertung für Ihr Projekt mit den Modellen AS711 bzw. AS713 an.


Rezensionen
Filter löschenEs gibt noch keine Rezensionen.